Лекция №4. Алгоритмы поиска и сортировки
Алгоритмы поиска
Линейный поиск
Линейный поиск подразумевает последовательный перебор всех элементов списка.
После обнаружения наилучшего значения выполняются действия, зависящие от условия задачи:
остановка обхода списка - “найти индекс первого элемента, который…”;
изменение значения переменной - “найти мин./макс. значение”, “определить есть ли …”, “посчитать количество …”;
вывод элемента на экран - “вывести все элементы, которые …”.
Обход элементов vs обход индексов списка
Если по условию задачи не нужно искать индекс подходящих элементов:
Результат:
Бинарный поиск
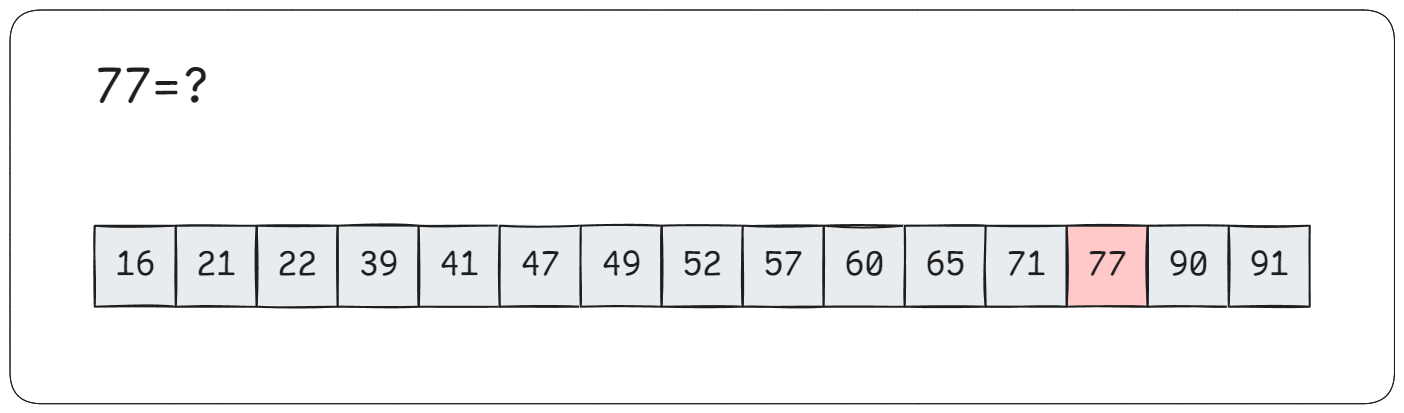
Бинарный поиск работает только для отсортированных списков.
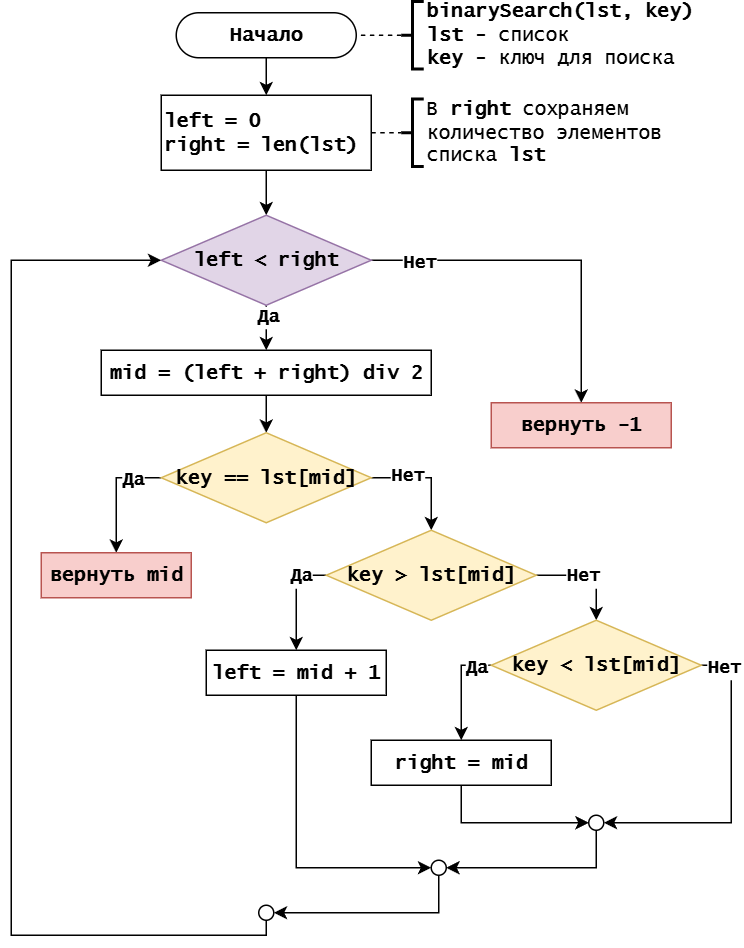
Найдём в списке значение равное \(key\). Пусть \(mid\) - индекс элемента в середине, \(K_{mid}\) - значение элемента в середине списка:
- Если \(key = K_{mid}\), значит элемент найден.
- Если \(key < K_{mid}\), значит искомое число меньше числа по индексу \(mid\).
- Если \(key > K_{mid}\), значит искомое число больше числа по индексу \(mid\).
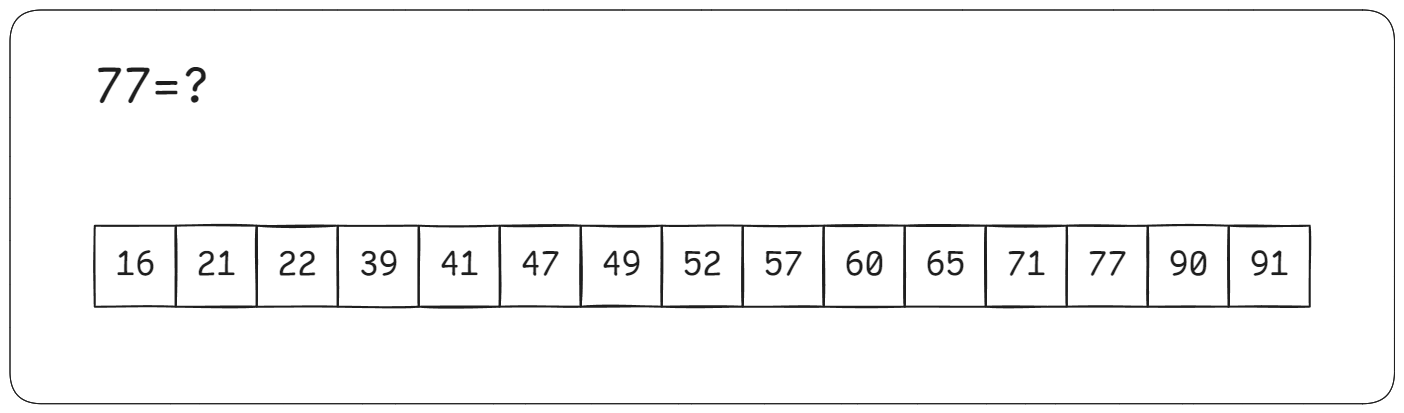
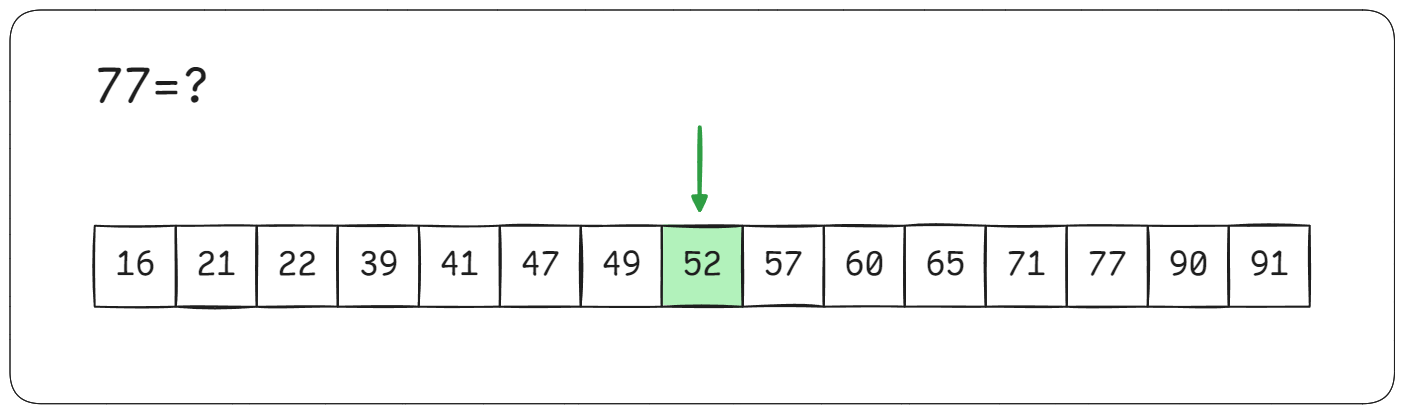
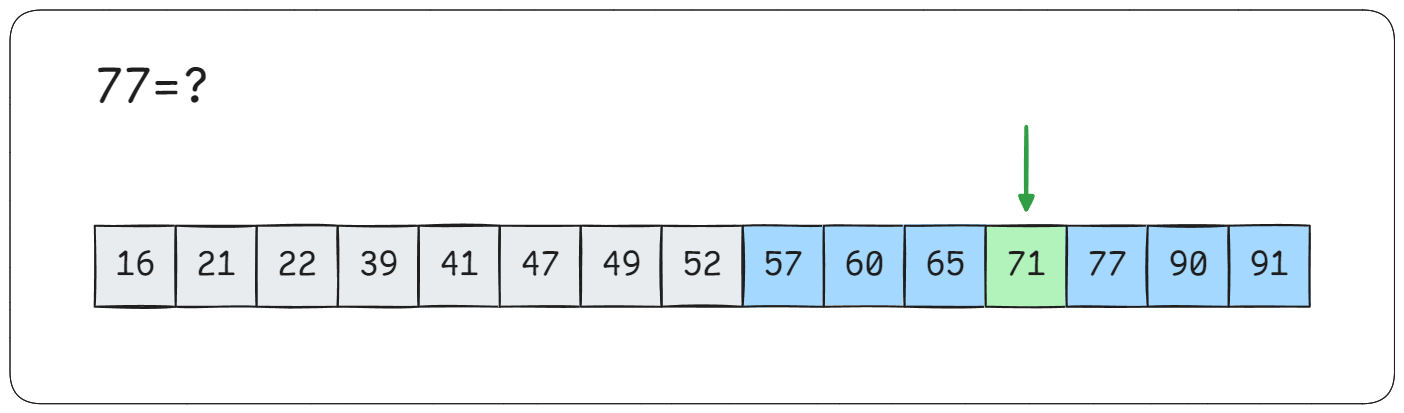
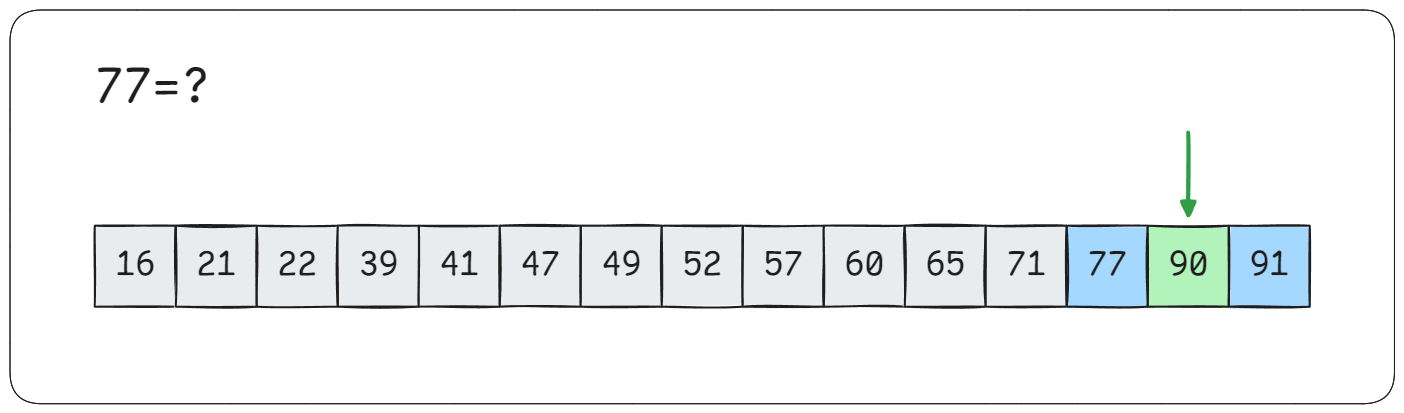
Блок-схема алгоритма
Алгоритмы сортировки
Сортировка элементов массива
Задача алгоритма сортировки - расположить элементы массива таким образом, чтобы определённое отношение выполнялось для любой пары соседних элементов.
- 3, 6, 7, 10, 11, 12, 20, 24
a[i] < a[i+1]
- “a”, “an”, “the”, “then”, “image”, “window”
длина a[i] < длина a[i+1]
- “at”, “bat”, “cat”, “dog”, “mouse”, “rat”
алфавитный порядок
Алгоритмы сортировки
- Сортировка простым обменом (пузырьковая сортировка)
- Сортировка выбором
- Сортировка вставками
- Сортировка подсчётом
- Сортировка слиянием
- Быстрая сортировка
- …
Сортировка простым обменом
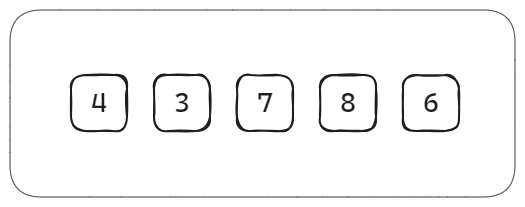
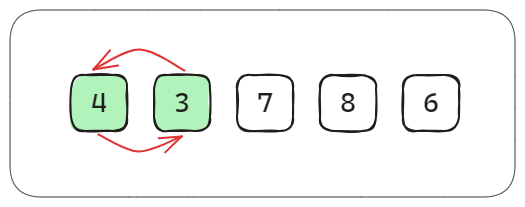
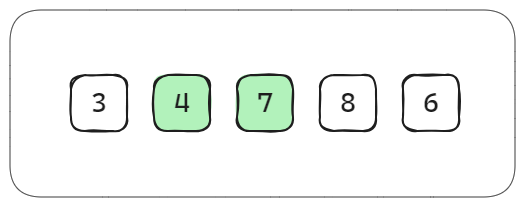
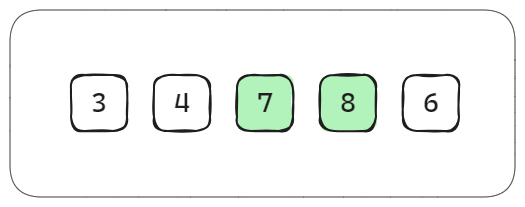
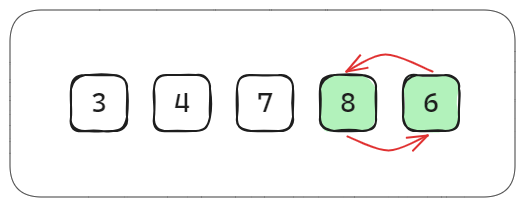
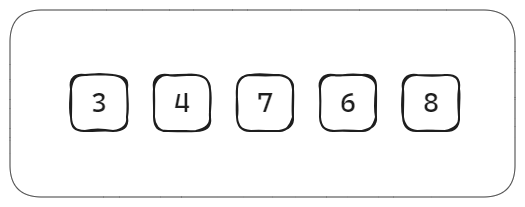
- Сравниваем пары соседних чисел. Меняем их местами, если числа расположены не в заданном порядке.
- После первого прохода алгоритма хотя бы одно число будет стоять на правильной позиции.
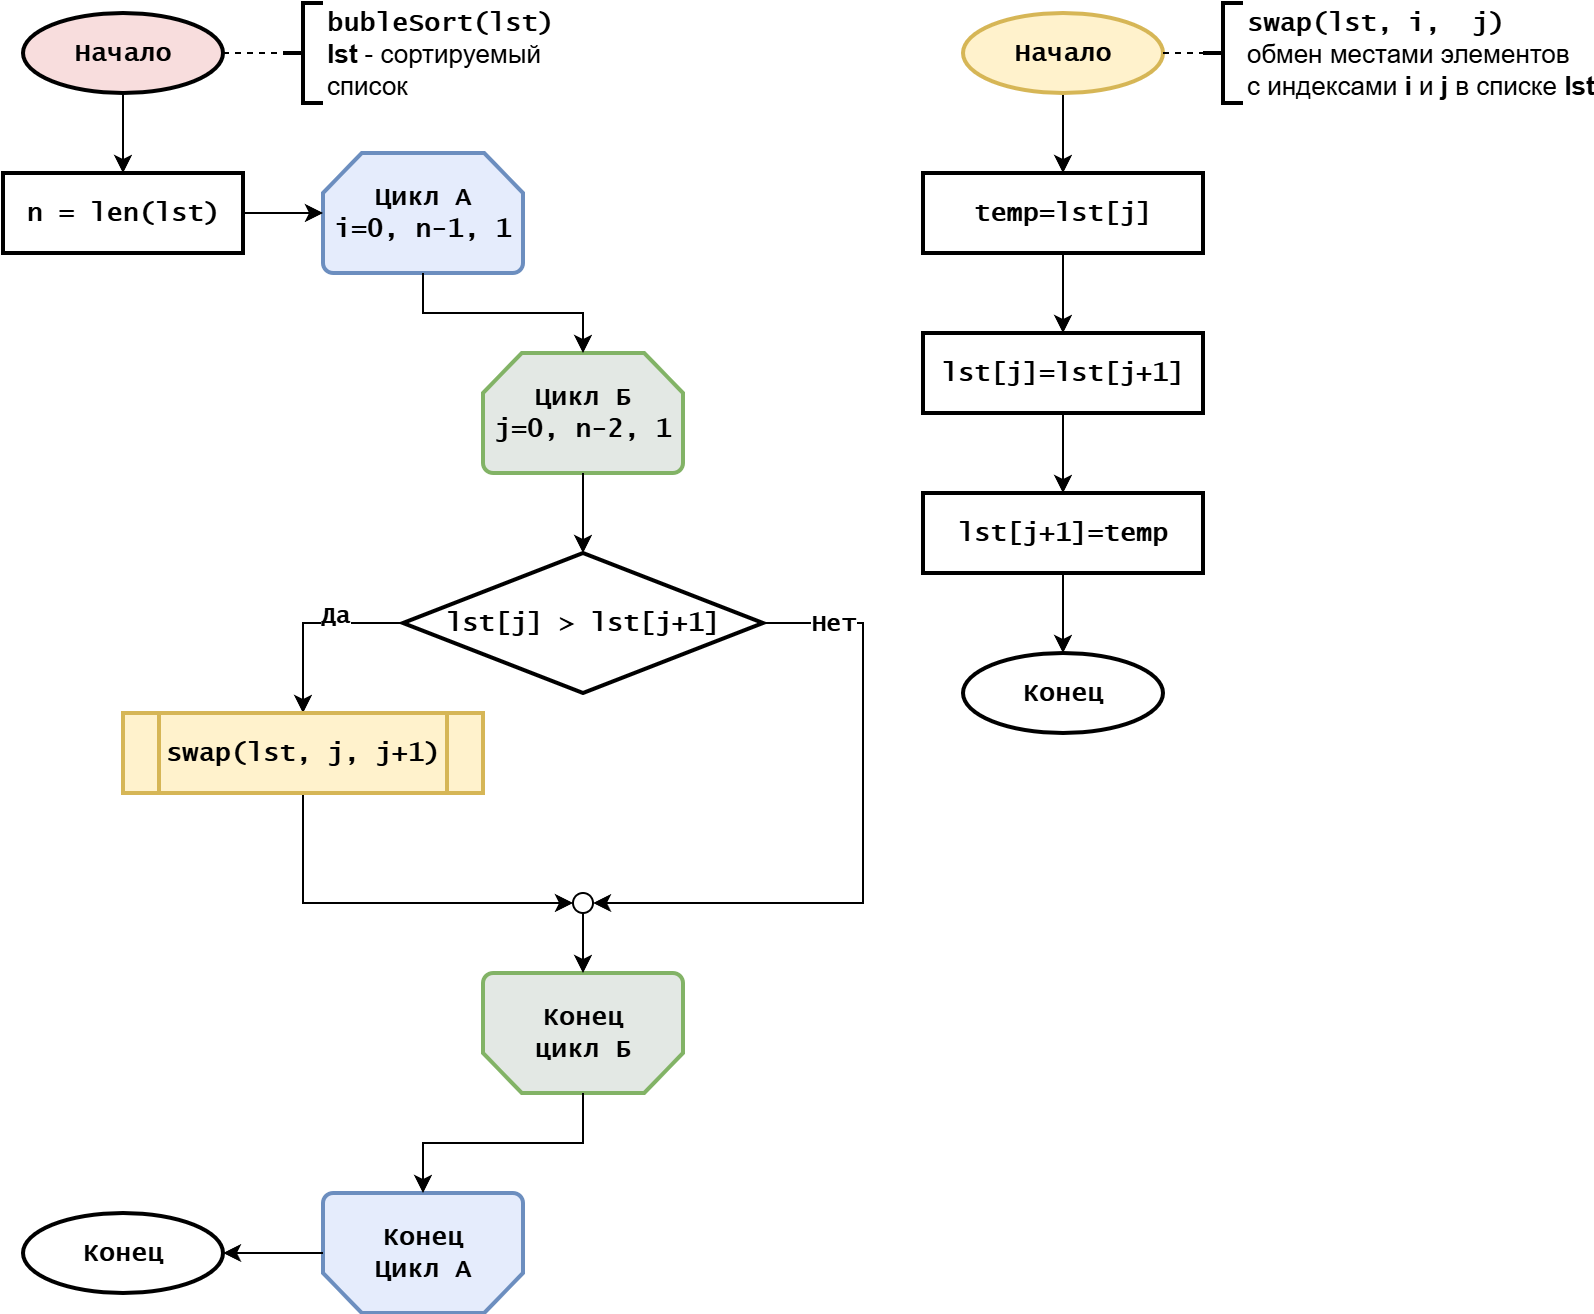
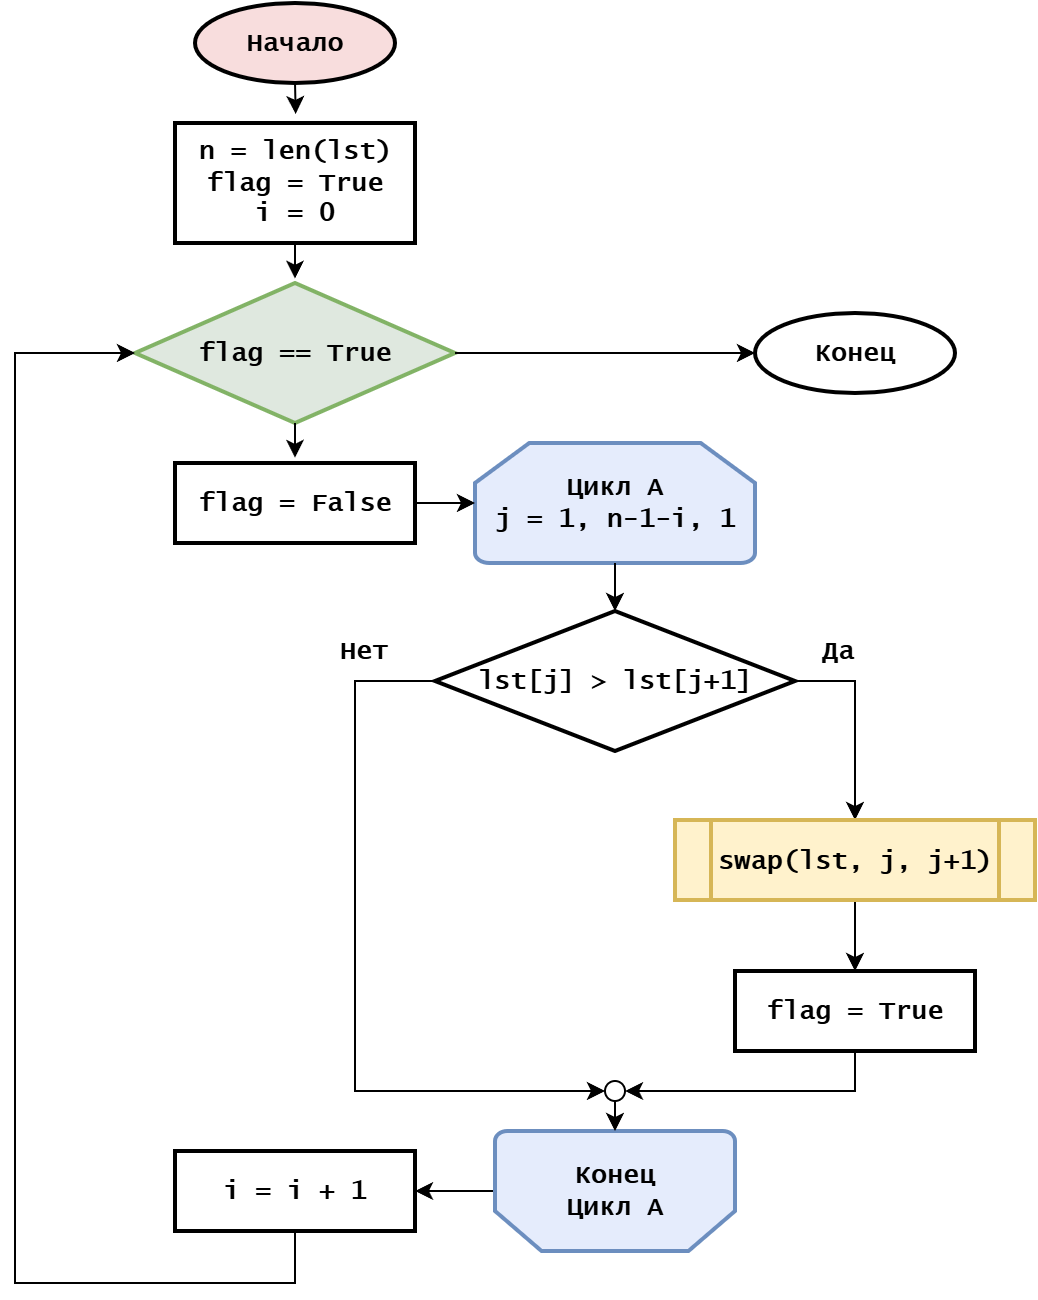
Возможны две оптимизации:
- сократить количество итераций вложенного цикла;
- прекращать сортировку, если на очередной итерации внешнего цикла не произошло перестановок.
Оптимизация метода
- 1 проход алгоритма:
n-1сравнение - 2 проход алгоритма:
n-2сравнений - и т.д.
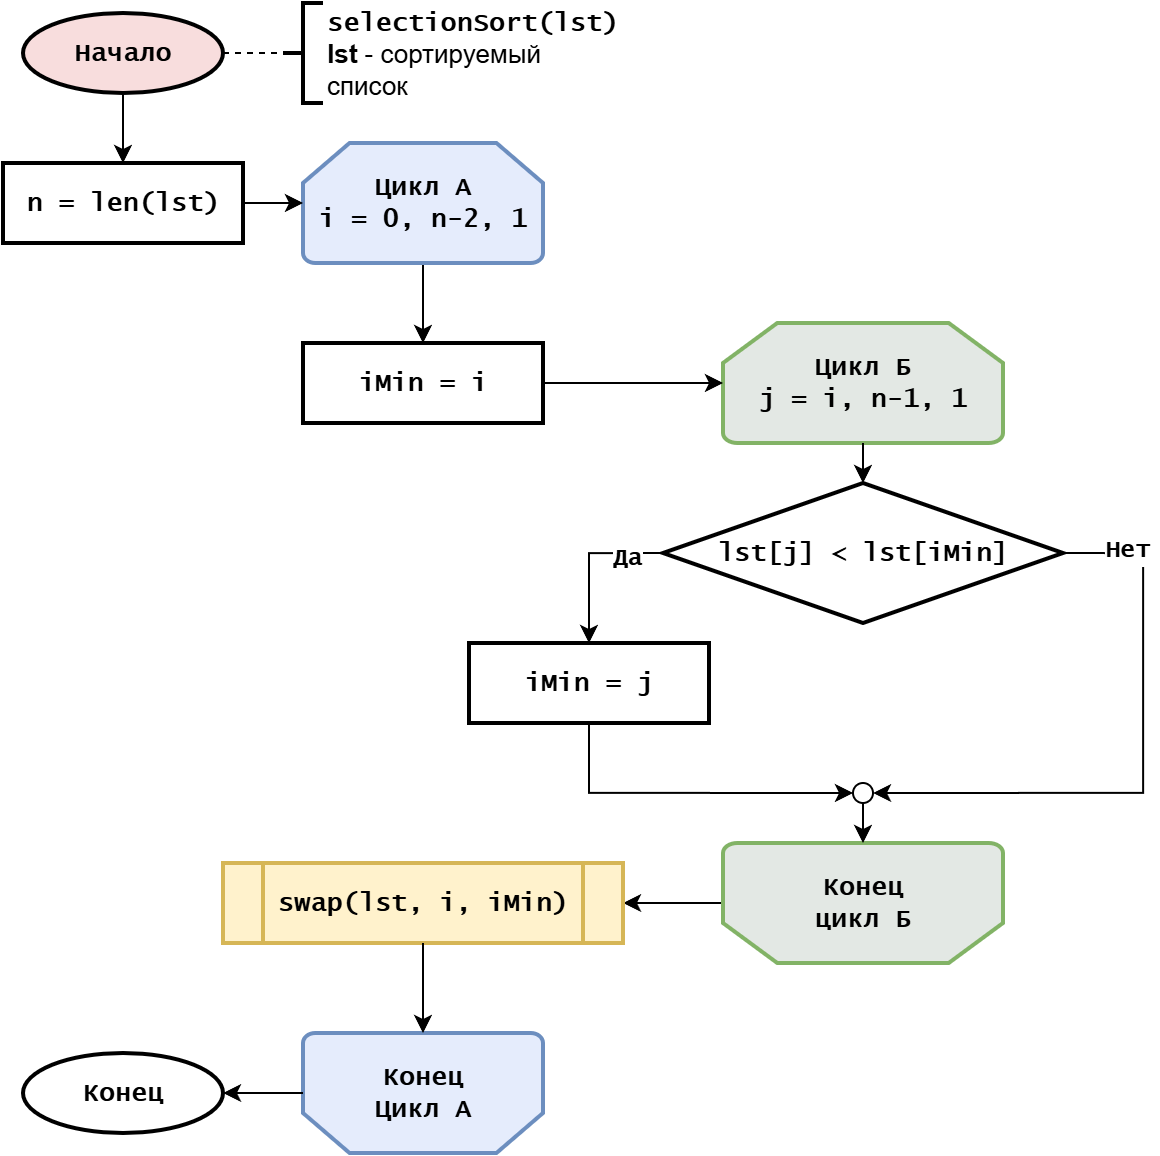
Сортировка выбором
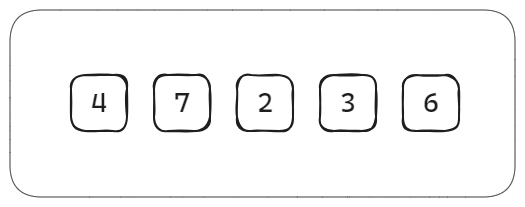
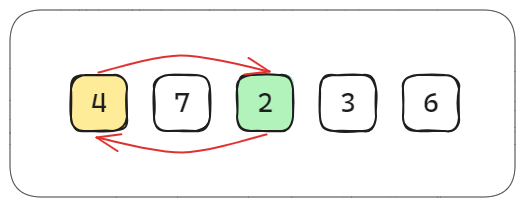
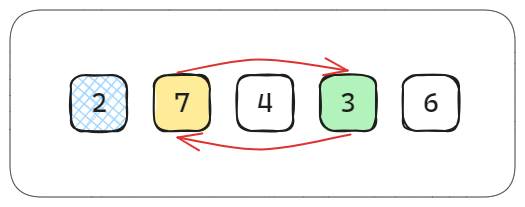
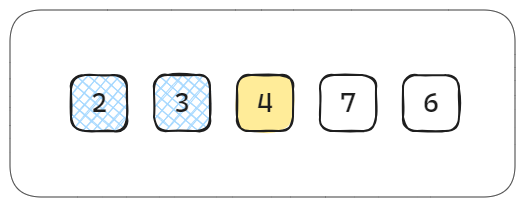
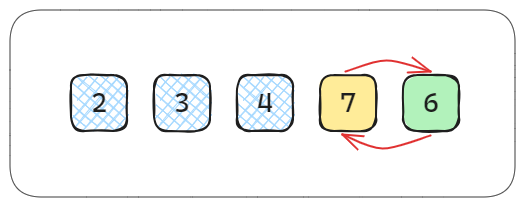
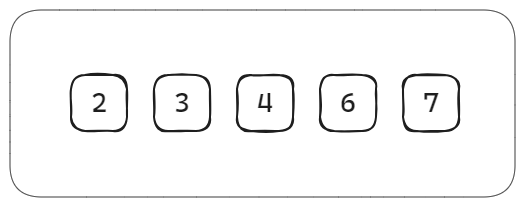
На каждом проходе алгоритма ищем минимальное значение в неотсортированной части массива и ставим его на текущую позицию.
Сортировка вставками
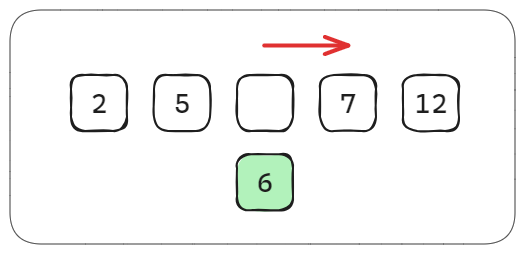
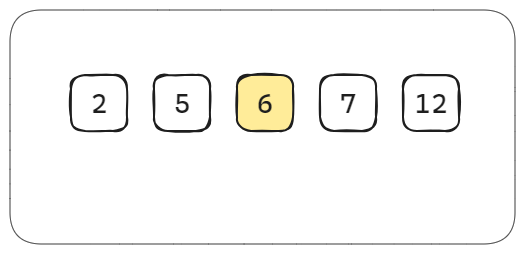
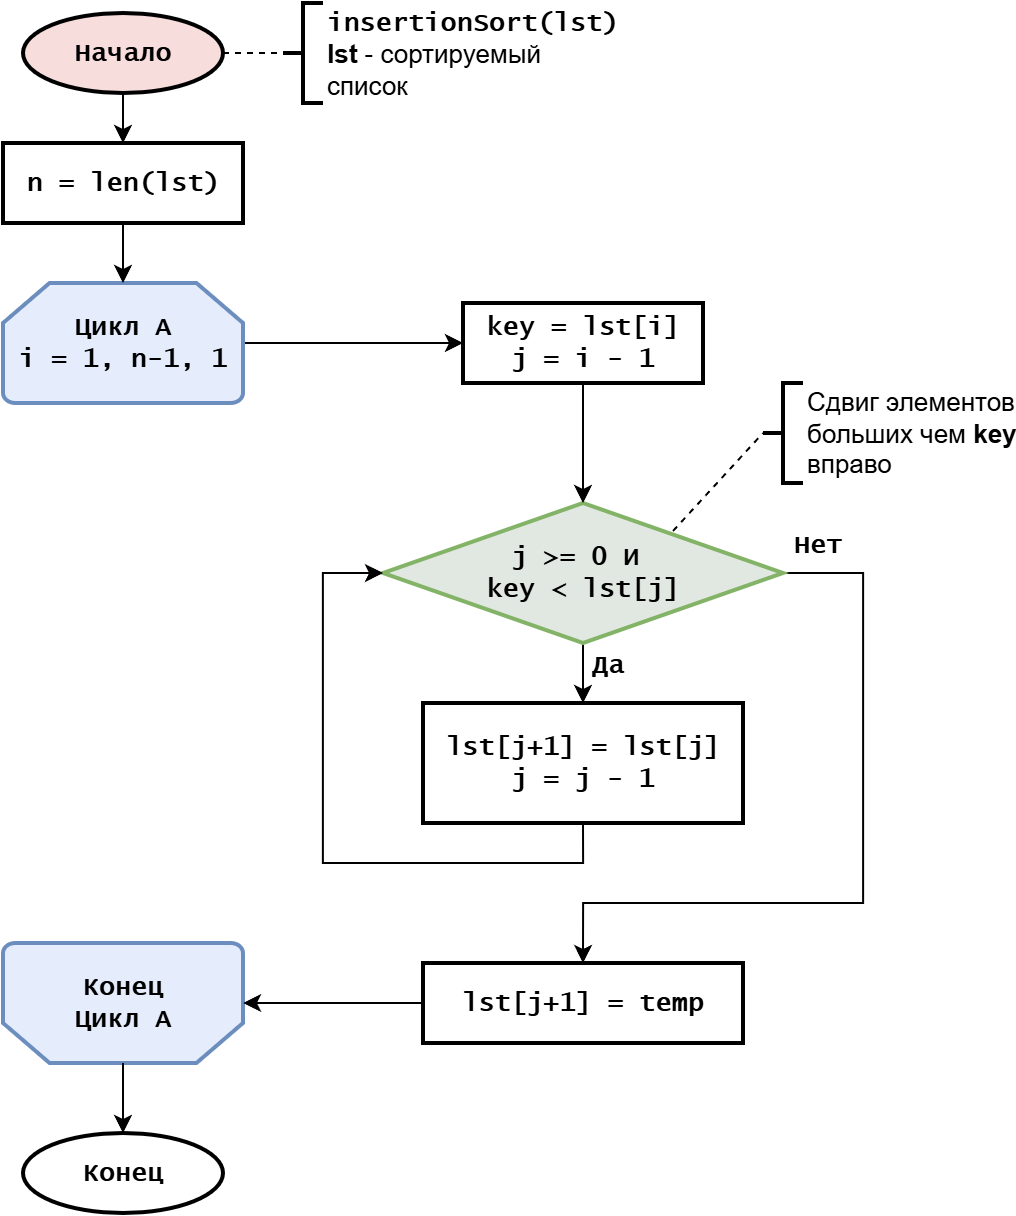
Типовые задачи на сортировку
- Поиск: сортировка данных и применение бинарного поиска.
- Поиск ближайшей пары: найти в множестве из n чисел два числа с наименьшей разностью между ними.
- Определение уникальности элементов: имеются ли дубликаты в множестве из n элементов? (Найти два соседних элемента разность которых равна 0).
- Частотное распределение: определение самого часто встречающегося элемента в множестве.
Сортировка в Python
В языке Python есть встроенная функция для сортировки последовательностей - sorted().
Функция может принимать в качестве аргумента любую последовательность и возвращает список отсортированных элементов.
Функция-ключ
Кроме последовательности, функция sorted() может принимать аргумент с именем key - функцию-ключ.
Функция применяется к каждому элементу последовательности перед началом сортировки.
Задача
Названия групп в электронном расписании сортируются в лексикографическом порядке. Организовать сортировку групп по году поступления.
Используем функцию в качестве ключа сортировки:
*Абстрактный тип данных “Хэш таблица”
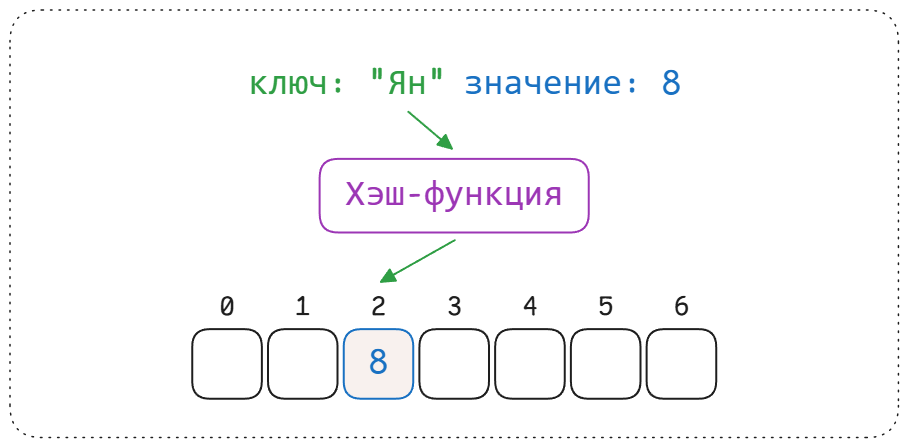
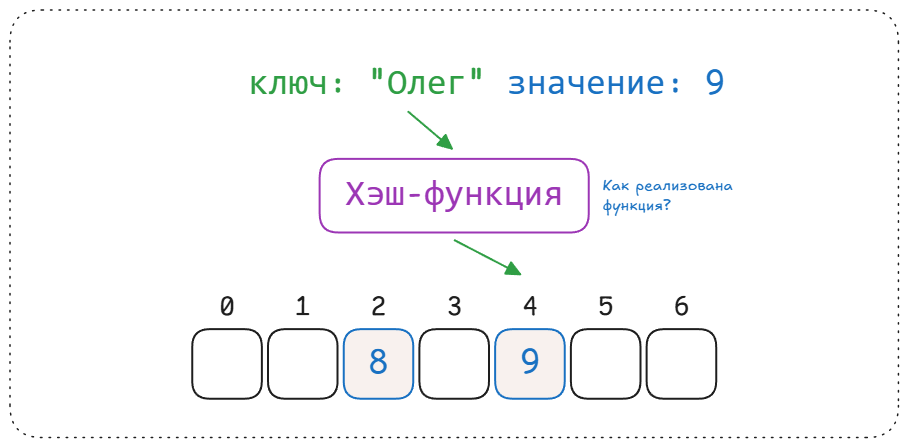
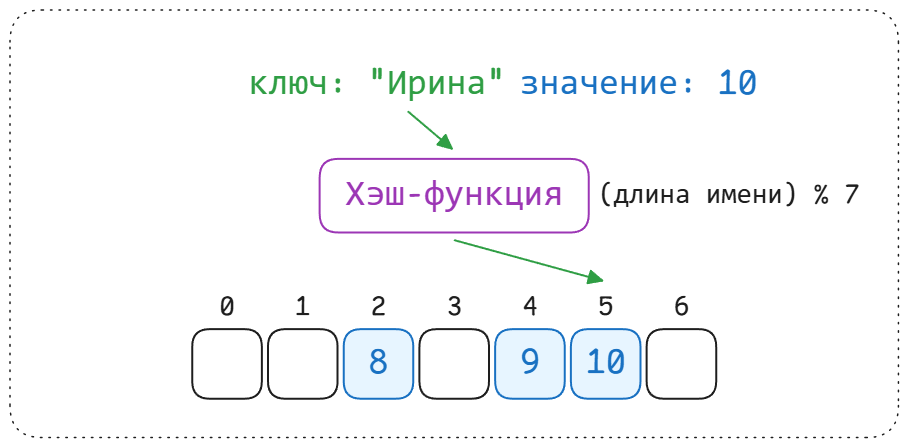
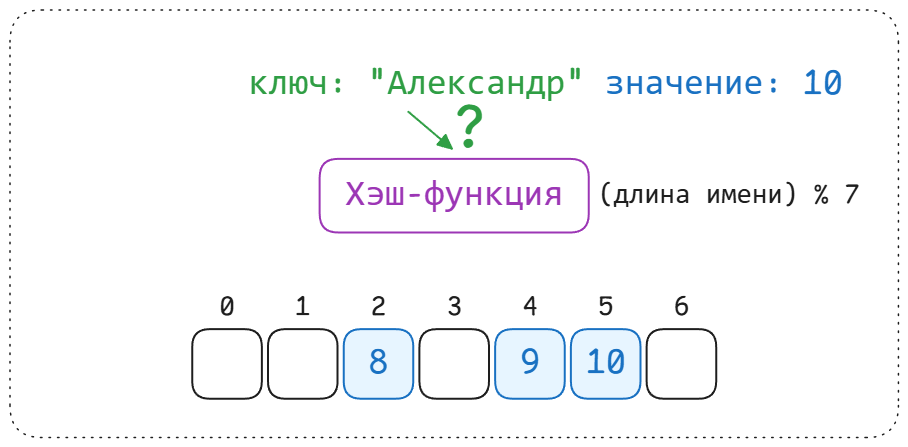
Хэш таблица хранит каждое значение под уникальным ключом.
Компоненты:
- список для хранения значений;
- хэш-функция, которая по значению ключа, вычисляет индекс для хранения значения в списке.
Реализация хэш таблиц
Задача - сохранить отметку за экзамен с привязкой к имени студента.
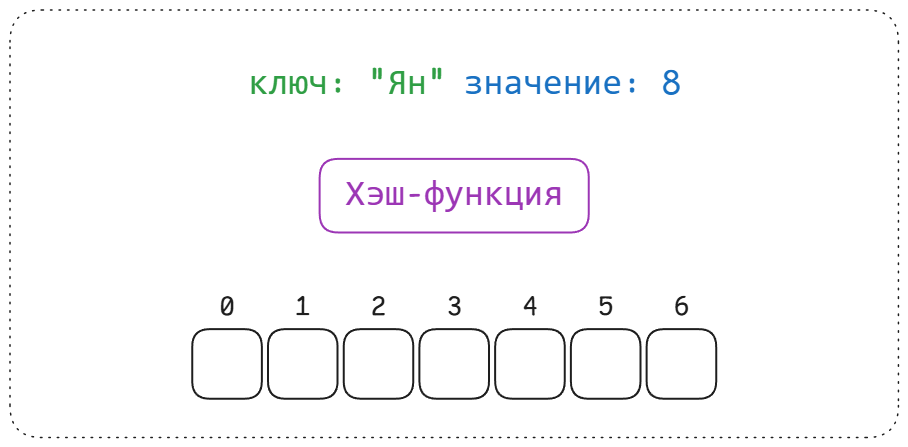
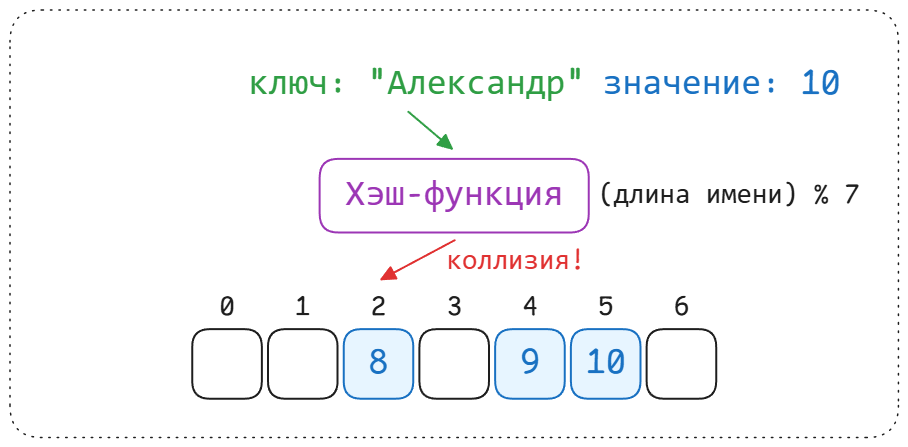
Реализация в Python
Словарь – это набор ключей и соответствующих им значений.
Данные в словаре не упорядочены.
В Python словарю соответствует тип dict.
Добавление и получение значений из словаря
Квадратные скобки [] позволяют добавить и получить значение из словаря.
Тип ключей в словаре
Ключами в словаре могут быть значению любого неизменяемого типа: int, float, str.
# целочисленный ключ, строковое значение
num_names={1:"Один", 2: "Два", 3:"Три"}

# вещественный ключ, строковое значение
dec_names={1.5:"Одна целая, пять десятых", 2.5: "Два с половиной"}

# строковый ключ, целочисленное значение
roman_nums = {'I':1, 'II':2, 'III':3, 'IV':4, 'V':5}

# строковый ключ, значение - список
shop = {'фрукты': ['ананас', 'банан'], 'овощи': ['огурец', 'капуста']}shop["фрукты"][1]?
Методы класса dict
dict
| Метод | Значение |
|---|---|
<словарь>.get(<ключ>)<словарь>.get(<ключ>, <значение>) |
Если в словаре есть <ключ> - получить его значение, иначе вернуть <значение> |
<словарь_1>.update(<словарь_2>) |
Обновить содержимое <словарь_1> парами ключ-значение из <словарь_2> |
<словарь>.keys() |
Получить список ключей |
<словарь>.values() |
Получить список значений |
Пример задачи
Пользователь вводит с клавиатуры строку с текстом. Программа должна подсчитать, сколько раз в тексте встречается каждое из слов. Слова в тексте разделяются пробелом.